


 |
| /사진=네이버 |
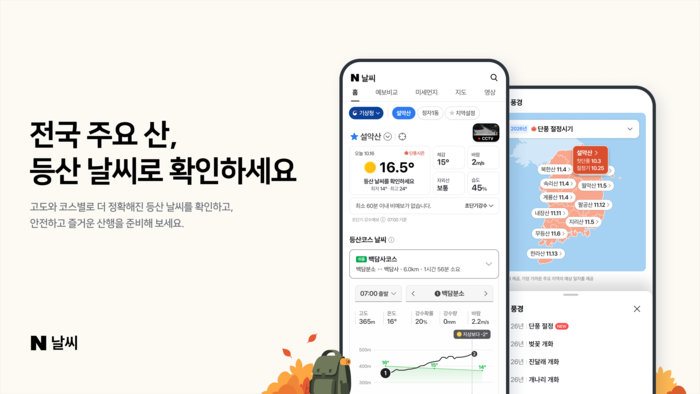
▲네이버, 등산 코스와 시간별 맞춤형 ‘초단기 예보’ 서비스
네이버는 지난 9월 전국 301개 주요 산의 좌표 기준 초단기 예보를 제공하는 ‘등산 테마날씨’를 출시했고, 495개 골프장, 30개 축구장, 20개 야구장 등 총 868개의 테마날씨를 통해 이용자 맞춤형 날씨 정보를 제공하고 있다고 8일 밝혔다.
‘등산 테마날씨’는 광범위한 인근 행정동이 아닌 좌표 기준으로 날씨 정보를 제공한다. 또한 네이버 지도가 보유한 등산 코스 데이터를 시간대별 예보에 맞춰 재가공해 ‘등산 코스 날씨’를 추가한 게 특징이다. 이용자가 오르려는 산의 코스, 출발 시간을 선택하면 실제 산행에 이어지는 시간의 흐름에 따라 기온, 바람, 강수의 변화를 구간별로 미리 확인할 수 있다.
또한 네이버는 산행 계획과 더불어 일출 시각도 안내하는데, 코스와 출발 시간 단위로 날씨를 안내하는 방식을 국내 최초로 제공한다. 이와 함께 단풍과 개화 시기 등을 안내하는 ‘계절 풍경’ 정보를 제공하는 것도 특징이다.
네이버 날씨 화면 안에서 ‘계절 풍경’을 상시 확인해서 등산 계획, 단풍놀이 나들이 계획을 세우는 데 참고할 수 있고 향후 등산 외에 연관성이 높은 다른 테마에도 순차적으로 확대 적용할 계획이다.
한편 네이버는 지난해 8월 야구장을 시작으로 12월 테마파크, 스키장, 올해 2월 축구장, 4월 골프장의 테마날씨를 서비스하며 호평을 받아왔고, 9월 말 기준 누적 구독 21만 3천여 건을 기록했다. 이는 올해 1월 7만 3천여 건과 비교하면 8개월 만에 2.9배 늘어난 규모고 가장 많이 구독된 곳은 잠실야구장(2만 5천여 건)이다.
김혜진 네이버 리더는 “네이버 날씨는 단순 예보를 빠르고 정확하게 전달하는 것을 넘어, 날씨와 관련된 맞춤형 정보를 제공하기 위해 지속적으로 진화했다”라며 “계절성 요인이 있는 다른 테마와 다르게 사계절 내내 수요가 이어지는 등산을 여섯 번째 테마로 선보였고 연내 ‘바다낚시’ 테마를 더해 주요 야외 활동 전반을 아우르겠다”라고 밝혔다.
 |
| /사진=카카오 |
▲카카오, 언어모델링 국제학회 ‘COLM 2026’에서 AI 연구 성과 발표
카카오는 언어모델링 국제 학회 ‘COLM(Conference on Language Modeling) 2026’에서 대규모 전문가 혼합(MoE, Mixture-of-Experts) 모델의 학습 효율을 높이는 기술과 모델 크기를 줄이면서도 성능을 개선하는 경량화 기술을 발표했다고 밝혔다.
COLM은 대규모 언어모델(LLM)과 언어모델링 연구를 전문적으로 다루는 국제 학회로, 지난 2024년 신설됐다. 카카오는 이번 학회의 메인 컨퍼런스와 토크나이제이션(Tokenization) 워크숍 ‘TokShop’에서 각각 성과를 소개했다.
메인 컨퍼런스에서 발표한 논문 ‘Let’s Scale Step by Step: Compute-Efficient Hyperparameter Transfer for Large-Scale Mixture-of-Experts’는 대규모 MoE 모델의 사전 학습에 필요한 최적의 학습률을 전체 학습 비용의 약 1% 수준으로 예측하는 방법론을 담았다. 학습률(Learning Rate)은 AI 모델이 학습할 때 내부 설정값인 ‘매개변수’를 얼마나 크게 조정할지 정하는 값이다. 너무 크면 학습이 불안정해지고, 너무 작으면 학습 속도가 느려질 수 있어 적절한 값을 찾는 것이 중요하며 학습의 안정성과 성능에 영향을 미친다.
MoE 모델은 최근 고성능 LLM의 핵심 구조로 주목받고 있지만, 기존 Dense(밀집형) 모델에 비해 학습 설정과 방법에 관한 공개 연구가 충분하지 않다. 이에 대규모 학습 시 비용에 대한 부담과 시행착오가 발생할 수 있다.
카카오는 소규모 모델에서 찾은 최적의 학습 설정을 대규모 모델로 확장하는 ‘뮤-매개변수화(μ-Parameterization)’ 기법을 MoE 모델 구조의 특성에 맞게 적용했다. 모델의 크기와 학습 토큰량을 단계적으로 확장하며 최적의 학습률을 탐색하고, 짧은 학습 구간에서 찾은 설정이 대규모 학습에서도 유효하게 적용됨을 검증했다. 이 방법론은 카카오의 ‘Kanana-2.6-155b-a17b’ 모델의 사전학습에 실제로 적용돼 10조(10T) 토큰까지 안정적으로 학습하는 데 활용됐다.
또한, TokShop에서는 모델 크기를 줄이면서도 성능을 높인 ‘BBT: BPE-Guided Byte Transformer’를 공개했다. 기존 BPE(Byte Pair Encoding, 문자 조합 토큰 생성 방식) 기반 모델은 글을 읽고 답변을 생성하기 위해 수많은 단어와 단어 조각에 해당하는 정보를 저장해야 한다. BBT는 이를 더 작은 기본 단위인 ‘바이트’를 활용하는 구조로 바꿔 모델의 크기를 줄이면서, 여러 문자를 묶어 효율적으로 압축 처리하는 기존 방식의 장점은 유지했다.
BBT는 비교 실험에서 파라미터 수를 20.2~40.4% 줄이면서 테스트 성능을 2.7~6.6% 개선했다. 또한 오탈자나 문자 교란에 대한 강건성을 확보하고, 학습하지 않은 언어로의 전이 성능도 높였다. 이를 통해 온디바이스 환경에서 AI 모델의 메모리 부담을 줄이고, 다국어 입력이나 오탈자가 잦은 대화 환경에서도 안정적인 성능을 구현하는데 기여할 것으로 기대된다.
카카오는 앞으로 다양한 모델 구조로 적용 범위를 넓히고, 효율적인 방법을 고도화해 대규모 LLM의 학습 비용을 더욱 절감할 계획이다.
카카오 관계자는 “이번 연구들은 AI 모델의 성능을 유지하거나 향상시키면서도 학습 및 운영 비용을 낮출 수 있는 실용적인 해법을 제시했다는 데 의의가 있다”며 “앞으로 다양한 모델 구조와 멀티모달 및 다국어 환경으로 연구를 확장해 실제 서비스 활용 가능성을 높이며 글로벌 경쟁력 강화를 이어가겠다”고 말했다.
최형균 기자 chg@
〈ⓒ 대한경제신문(www.dnews.co.kr), 무단전재 및 수집, 재배포금지〉

