


코딩 에이전트 비용 90% 절감 사례
모델 라우팅·경량화·칩 혼용 묶어
내년 기업 대상 토큰 사업 본격화
KT·SKT와 달리 ‘원가’ 절감 공략
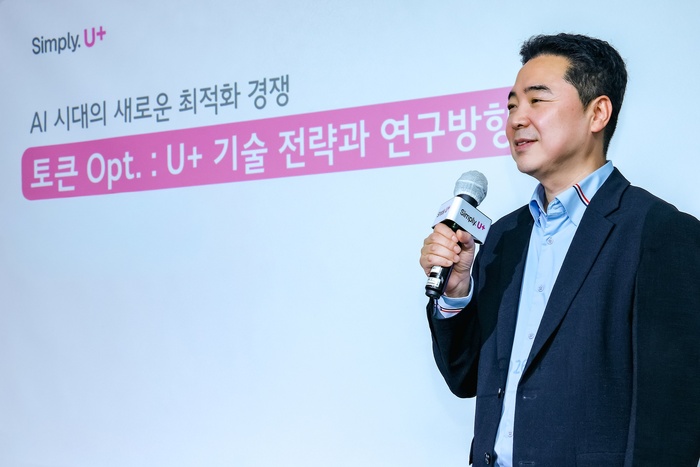 |
| LG유플러스는 12일 기자들을 대상으로 ‘AI 토큰 최적화 스터디’를 개최하고, 실제 상용 환경에서 입증한 AI 비용 절감 핵심 기술과 연구 성과, 향후 사업 추진 방향을 공개했다. 사진은 이상엽 LG유플러스 최고기술책임자(CTO)가 스터디 현장에서 발표하는 모습./사진=LG유플러스 |
[대한경제=최형균 기자] LG유플러스가 인공지능(AI)이 일을 끝내는 데 드는 토큰 비용을 줄이는 기술을 내년 기업간거래(B2B) 사업으로 키운다. 연말 정식 출시하는 정부의 전 국민 무료 AI 서비스 ‘모두의 AI’에서는 카카오 컨소시엄의 AI 모델을 돌리는 일(서빙)을 맡아 노하우를 쌓는다. KT가 여러 모델을 한 창구에서 골라 쓰게 하는 플랫폼을 내놓고 SK텔레콤도 비슷한 사업을 예고한 것과 달리, 같은 일을 토큰을 덜 쓰고 끝내는 원가 기술로 차별화하겠다는 계산이다.
LG유플러스는 12일 서울 서대문구 워드스페이스에서 연 기자 대상 스터디에서 토큰 비용 절감 기술과 연구 성과를 공개했다. 토큰은 AI가 글과 음성을 잘게 쪼개 처리하는 단위로, AI 이용료를 매기는 기준이 된다. 이혜진 LG유플러스 최고기술책임자(CTO)부문 기술전략담당은 “전기·가스·수도에 통신도 인프라가 됐고, 이제 토큰도 인프라의 영역에 들어왔다”고 말했다.
문제는 단가가 떨어져도 전체 지출은 오히려 늘어난다는 점이다. 이 담당은 토큰 단가가 1~2년 새 80% 내렸지만 에이전트를 포함한 토큰 지출은 계속 오르고 있다고 설명했다. 사람 몫의 일을 떠맡는 AI 에이전트가 검색과 검증을 되풀이하며 사람이 직접 AI를 쓸 때보다 토큰을 5배 더 쓰기 때문이다.
LG유플러스 토큰 최적화의 출발점은 일의 난이도에 맞춰 모델을 골라 보내는 모델 라우팅이다. 인사말 같은 간단한 질문은 작은 모델로, 복잡한 분석은 고성능 모델로 보낸다. 내부 시험에서 코딩 에이전트는 30% 이상, 일반 질문은 25% 이상 비용이 줄었다.
모델 크기와 토큰 수도 줄였다. LG유플러스의 AI 전화 앱 ‘익시오’에 들어가는 단말기 탑재(온디바이스) 모델은 LG AI연구원의 ‘엑사원’을 바탕으로 만든 소형 모델이다. 2.4~3기가바이트(GB)이던 크기를 800메가바이트(MB) 수준으로 줄이고도, 빅테크가 클라우드에서 돌리는 AI 모델 성능의 95% 수준을 유지한다.
쓰는 토큰 수도 줄였다. 통화에 자주 나오는 표현에 맞춰 단어 사전을 새로 짜, 통화 한 건을 처리하는 토큰을 약 18% 덜 쓰게 했다. 모델이 서버에서 돌아도 그대로 통하는 방식이다. 작은 모델이 답을 먼저 써 내려가고 큰 모델이 검증하는 ‘추측 디코딩’으로 토큰 생성 속도는 두 배 이상 빨라졌다. 이 연구로 쓴 논문 2편은 지난달 ‘뉴립스(NeurIPS) 2026’ 온디바이스 인텔리전스 워크숍에 채택됐다.
반도체도 섞어 쓴다. 질문을 이해하는 단계처럼 계산이 몰리는 일은 연산이 빠른 엔비디아 그래픽처리장치(GPU)에, 답변을 만들어 내는 단계는 메모리가 큰 AMD GPU에 맡긴다. 간단한 답변용 가벼운 모델은 전력 효율이 높은 퓨리오사AI의 신경망처리장치(NPU)에 올리는 ‘칩 믹스’ 전략이다. 서버 쪽에서는 모델 최적화 기업 옵트에이아이와 공동 연구로 같은 GPU가 처리하는 토큰을 최대 4배로 늘린 초기 성과를 냈다.
LG유플러스는 이 같은 최적화 기술을 묶어 내년 기업 대상 토큰 사업을 본격화할 계획이다. 기업이 쓰는 AI 모델과 서비스 환경에 맞춰 모델 라우팅과 경량화, 토큰 절감 기술을 적용하고, 작업의 연산량과 메모리 사용량에 따라 GPU·NPU를 나눠 써 같은 업무를 더 적은 비용으로 처리하도록 돕는다는 구상이다. 회사는 ‘모두의 AI’ 모델 서빙을 통해 대규모 서비스 운영 경험을 쌓고, 이를 기업용 서비스 기술로 연결할 방침이다.
이상엽 LG유플러스 CTO는 출시 초기 고난도 추론을 맡겼던 구글 ‘제미나이’의 트래픽이 점차 자체 모델로 넘어왔다고 설명했다. 사내 개발자의 코딩 에이전트도 화면은 그대로 두고 뒤에서 부르는 모델만 바꿔, 통상 쓰는 모델보다 운영비를 90%가량 아낀 사례가 나왔다.
다음 시험대는 모두의 AI다. 이 CTO는 “프런트는 카카오가 맡지만 모델 서빙은 우리가 한다”며 “여기서 연구될 레시피와 최적화 방법이 다양한 토큰 팩토리의 서비스 기술로 반영될 수 있을 것”이라고 말했다. 홍범식 LG유플러스 대표가 내건 ‘사람 중심 AI’도 비용과 맞닿아 있다. 이 CTO는 사람 중심 AI의 관건이 서비스를 얼마나 지속 가능하게 제공하느냐에 있다고 강조했다.
KT는 플랫폼부터 내놨다. 지난달 30일 출시한 기업용 AI 플랫폼 ‘토큰팩토리’다. 자체 개발한 ‘오토 모델 라우터’가 질문 난이도와 요구 품질, 비용을 따져 모델을 고른다. 입력 문장의 군더더기를 덜어 내는 프롬프트 압축까지 더해 토큰을 최대 25% 줄였다는 게 KT 측 설명이다. SK텔레콤은 지난달 8일 AI 사용 패턴을 관리해 알맞은 모델과 인프라로 잇는 ‘토큰 게이트웨이’를 신사업으로 예고했지만, 출시 시점과 요금은 아직 밝히지 않았다.
LG유플러스와 KT의 진단은 같다. 이 CTO는 “우리 경쟁 상대는 빅테크 모델이 아니다”며 “고객이 일을 얼마나 싸게 처리하도록 엔지니어링해 주느냐의 문제”라고 말했다. 박상원 KT AX사업부문장도 지난달 27일 토큰팩토리를 공개하며 경쟁의 축이 좋은 모델을 만드는 쪽에서 AI를 효율적으로 쓰게 돕는 쪽으로 옮겨 가고 있다고 했다.
해법은 갈린다. 모델 라우팅은 두 회사가 같이 쓰지만 그다음이 다르다. KT가 많은 모델을 한 창구에 모아 알맞은 것을 고르고 입력 문장을 덜어 내는 데 무게를 둔다면, LG유플러스는 모델 크기와 토큰 수를 직접 줄이고 반도체까지 나눠 쓴다.
두 회사가 내건 절감률은 기준부터 다르다. KT의 ‘토큰 최대 25% 절감’은 모델 자동 선택과 프롬프트 압축을 합쳐 질문을 처리하는 데 드는 토큰 양을 줄인 결과다. LG유플러스의 ‘운영비 90% 절감’은 사내 개발자가 쓰는 코딩 에이전트의 모델을 바꿔 아낀 비용으로, 한 업무에서 나온 사례다. 어느 쪽이 더 많이 줄였다고 바로 견주기 어려운 이유다.
최형균 기자 chg@
〈ⓒ 대한경제신문(www.dnews.co.kr), 무단전재 및 수집, 재배포금지〉

